
SDFormer: Vision-based 3D Semantic Scene Completion via SAM-assisted Dual-channel Voxel Transformer
Abstract
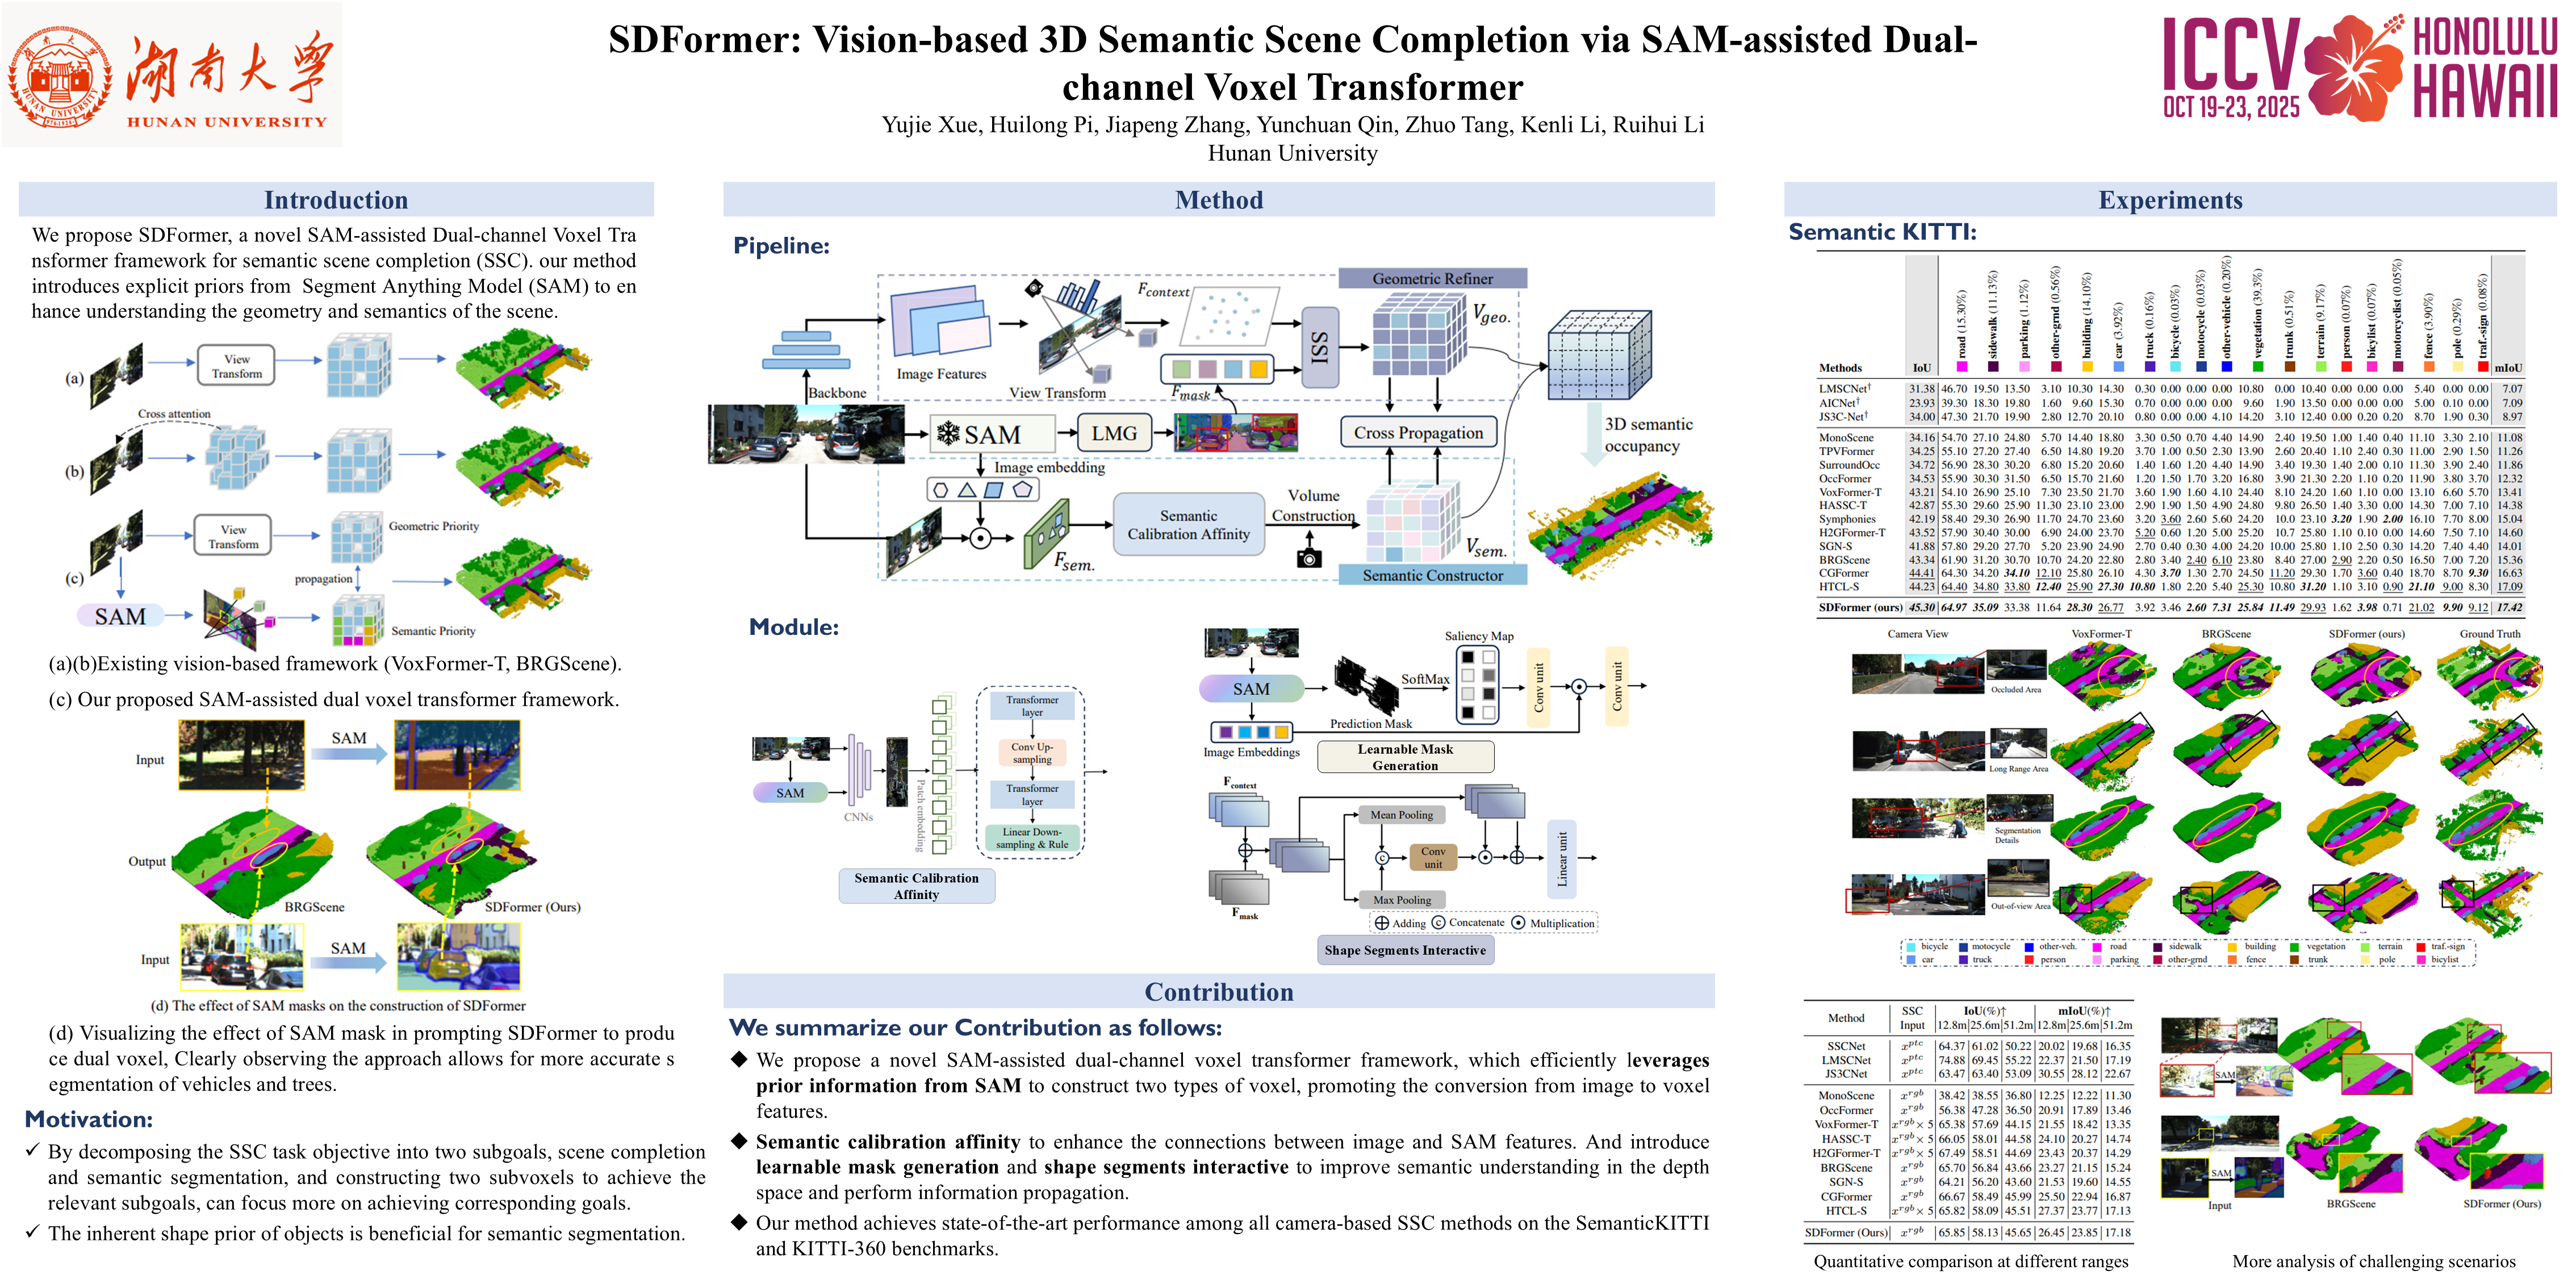
Vision-based semantic scene completion (SSC) is able to predict complex scene information from limited 2D images, which has attracted widespread attention. Currently, SSC methods typically construct unified voxel features containing both geometry and semantics, which lead to different depth positions in occluded regions sharing the same 2D semantic information, resulting in ambiguous semantic segmentation. To address this problem, we propose SDFormer, a novel SAM-assisted Dual-channel Voxel Transformer framework for SSC. We uncouple the task based on its multi-objective nature and construct two parallel sub-networks: a semantic constructor (SC) and a geometric refiner (GR). The SC utilizes the Segment Anything Model (SAM) to construct dense semantic voxel features from reliable visible semantic information in the image. The GR accurately predicts depth positions and then further adjusts the semantic output by SAM. Additionally, we design a Semantic Calibration Affinity to enhance semantic-aware transformations in SC. Within the GR, Shape Segments Interactive and Learnable mask generation module to emphasize the spatial location of semantics to obtain fine-grained voxel information. Extensive qualitative and quantitative results on the SemanticKITTI and SSCBench-KITTI-360 datasets show that our method outperforms state-of-the-art approaches.