
VLR-Driver: Large Vision-Language-Reasoning Models for Embodied Autonomous Driving
Abstract
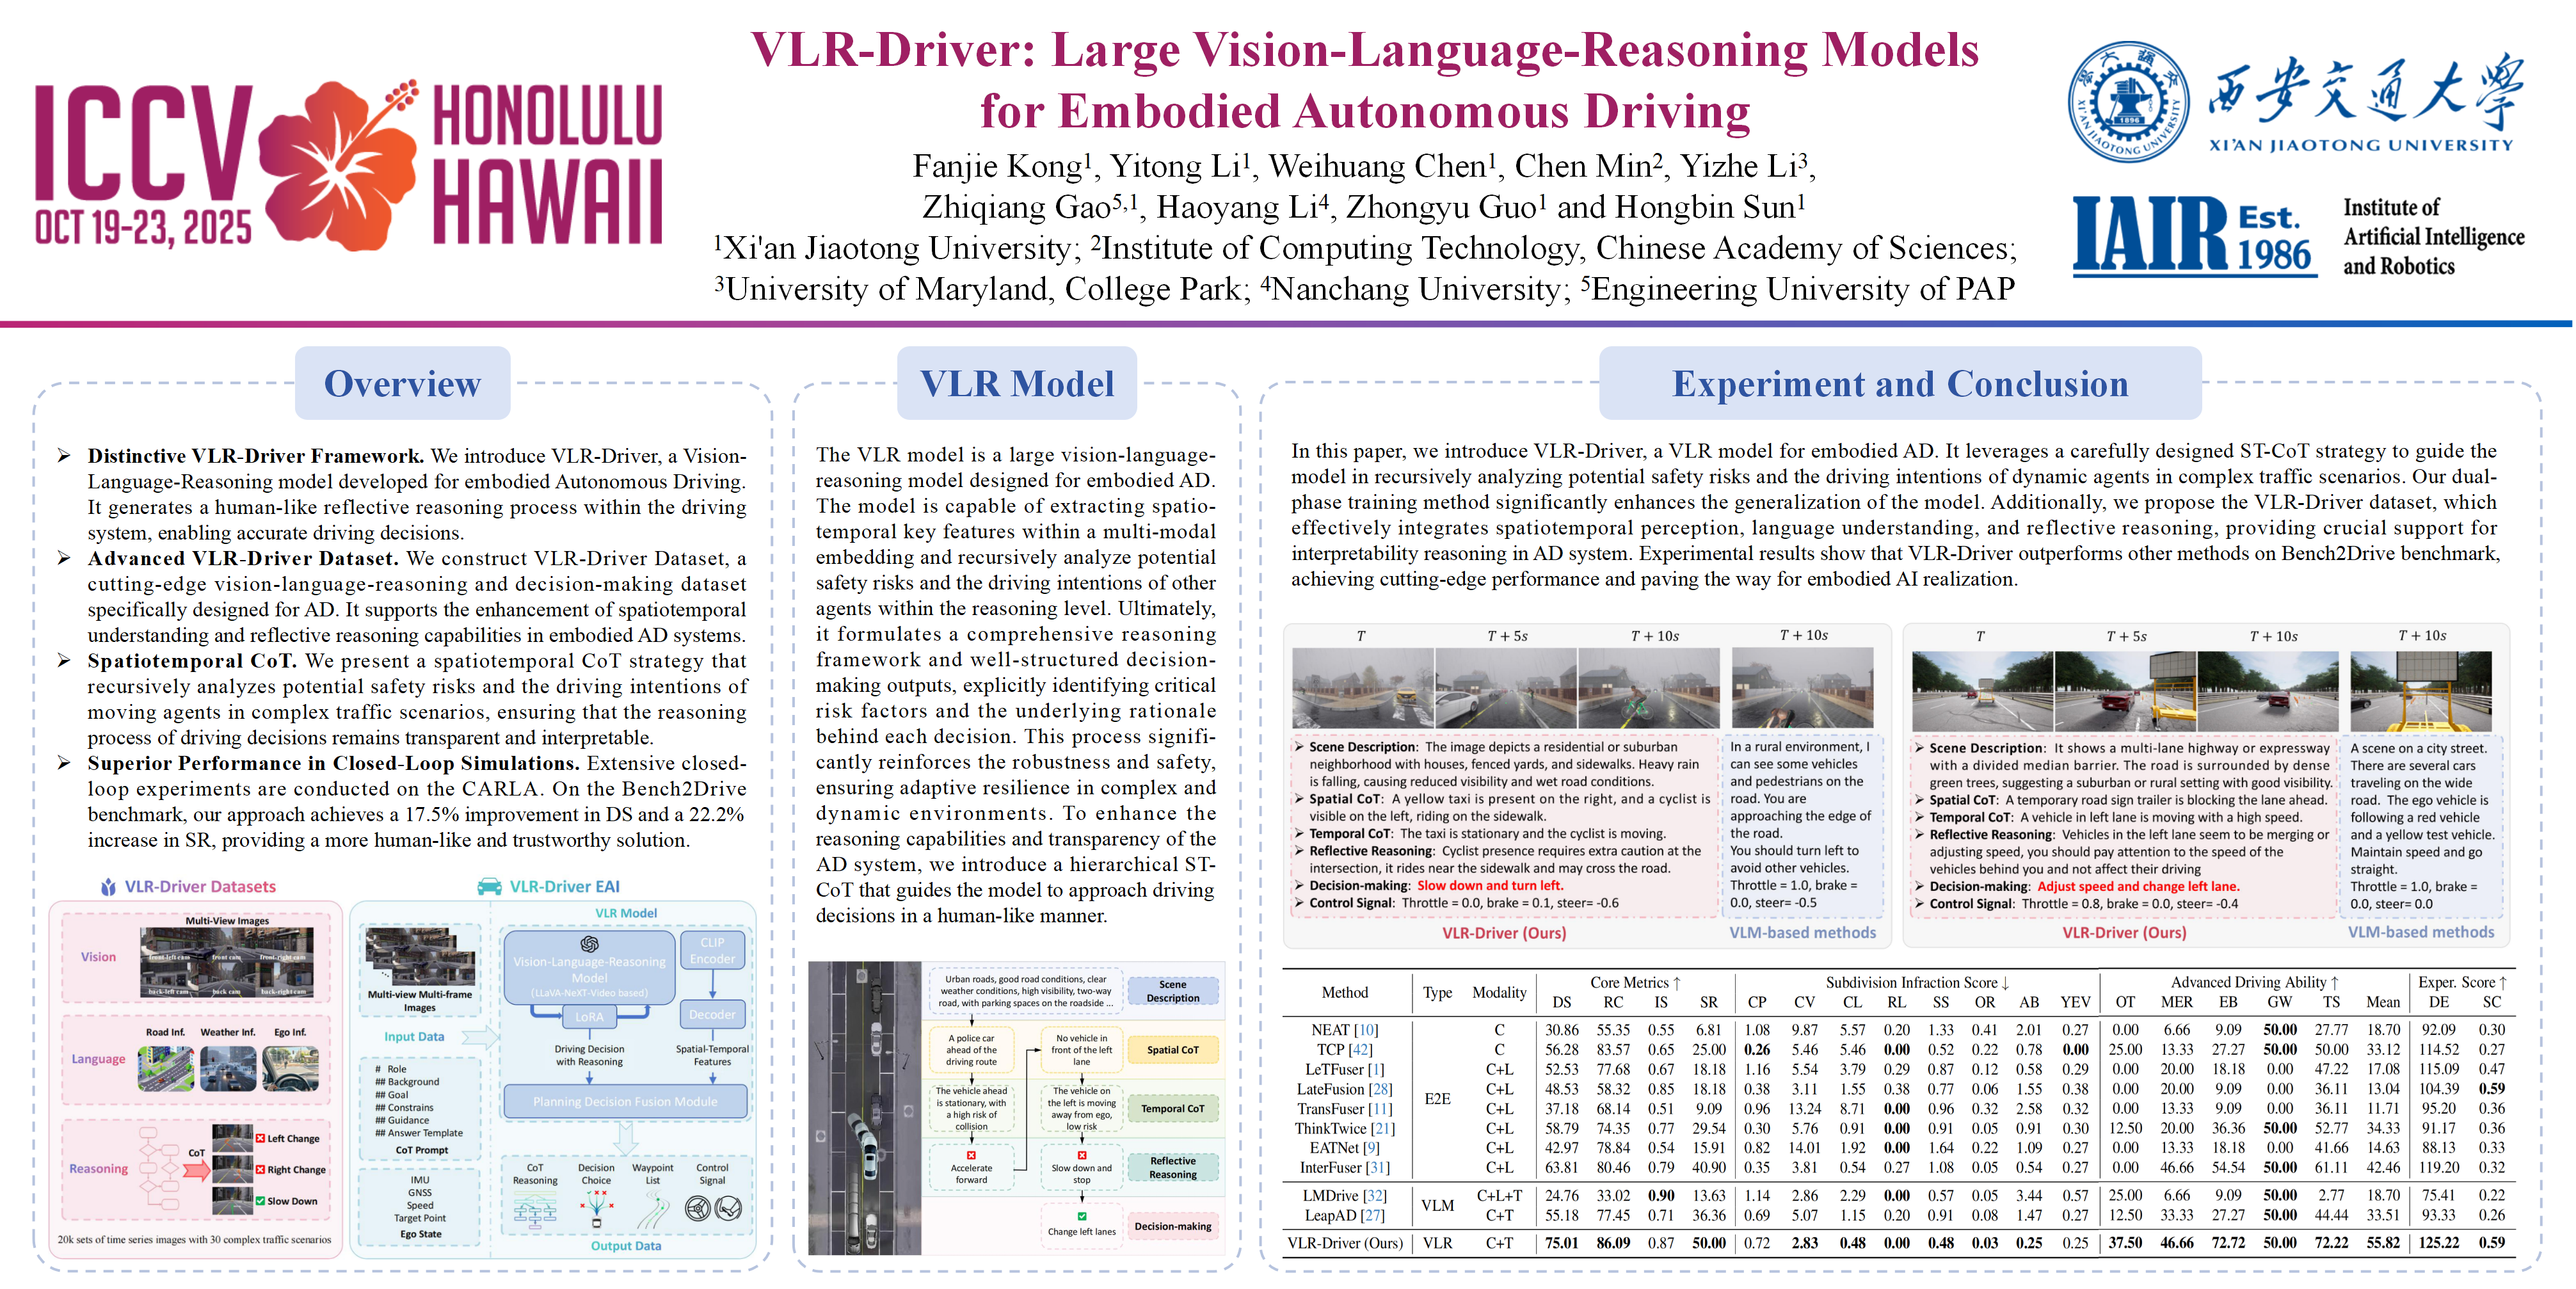
The rise of embodied intelligence and multi-modal large language models has led to exciting advancements in the field of autonomous driving, establishing it as a prominent research focus in both academia and industry. However, when confronted with intricate and ambiguous traffic scenarios, the lack of logical reasoning and cognitive decision-making capabilities remains the primary challenge impeding the realization of embodied autonomous driving. Although Vision Language Models (VLMs) have enhanced the deep semantic understanding of autonomous driving systems, they exhibit notable limitations in decision explainability when handling rare and long-tail traffic scenarios. In this paper, we propose VLR-Driver, a novel multi-modal Vision-Language-Reasoning (VLR) framework based on Chain of Thought (CoT) for embodied autonomous driving. The framework employs a spatiotemporal CoT reasoning approach to recursively analyze potential safety risks and driving intentions of other agents, thereby delivering an efficient and transparent decision-making process. Furthermore, we construct a multi-modal reasoning-decision dataset to support the advancement of hierarchical reasoning of VLMs in autonomous driving. Closed-loop experiments conducted in CARLA demonstrate that the VLR-Driver significantly outperforms state-of-the-art end-to-end methods. Notably, key metrics such as driving score improved by 17.5\%, while the success rate improved by 22.2\%, offering a more transparent, reliable, and secure solution for autonomous driving systems. The code, dataset, and demonstration video will be open-sourced.