
EFTViT: Efficient Federated Training of Vision Transformers with Masked Images on Resource-Constrained Clients
meihan wu ⋅ Tao Chang ⋅ Cui Miao ⋅ Jie Zhou ⋅ Chun Li ⋅ Xiangyu Xu ⋅ Ming Li ⋅ Xiaodong Wang
2025 Poster
Abstract
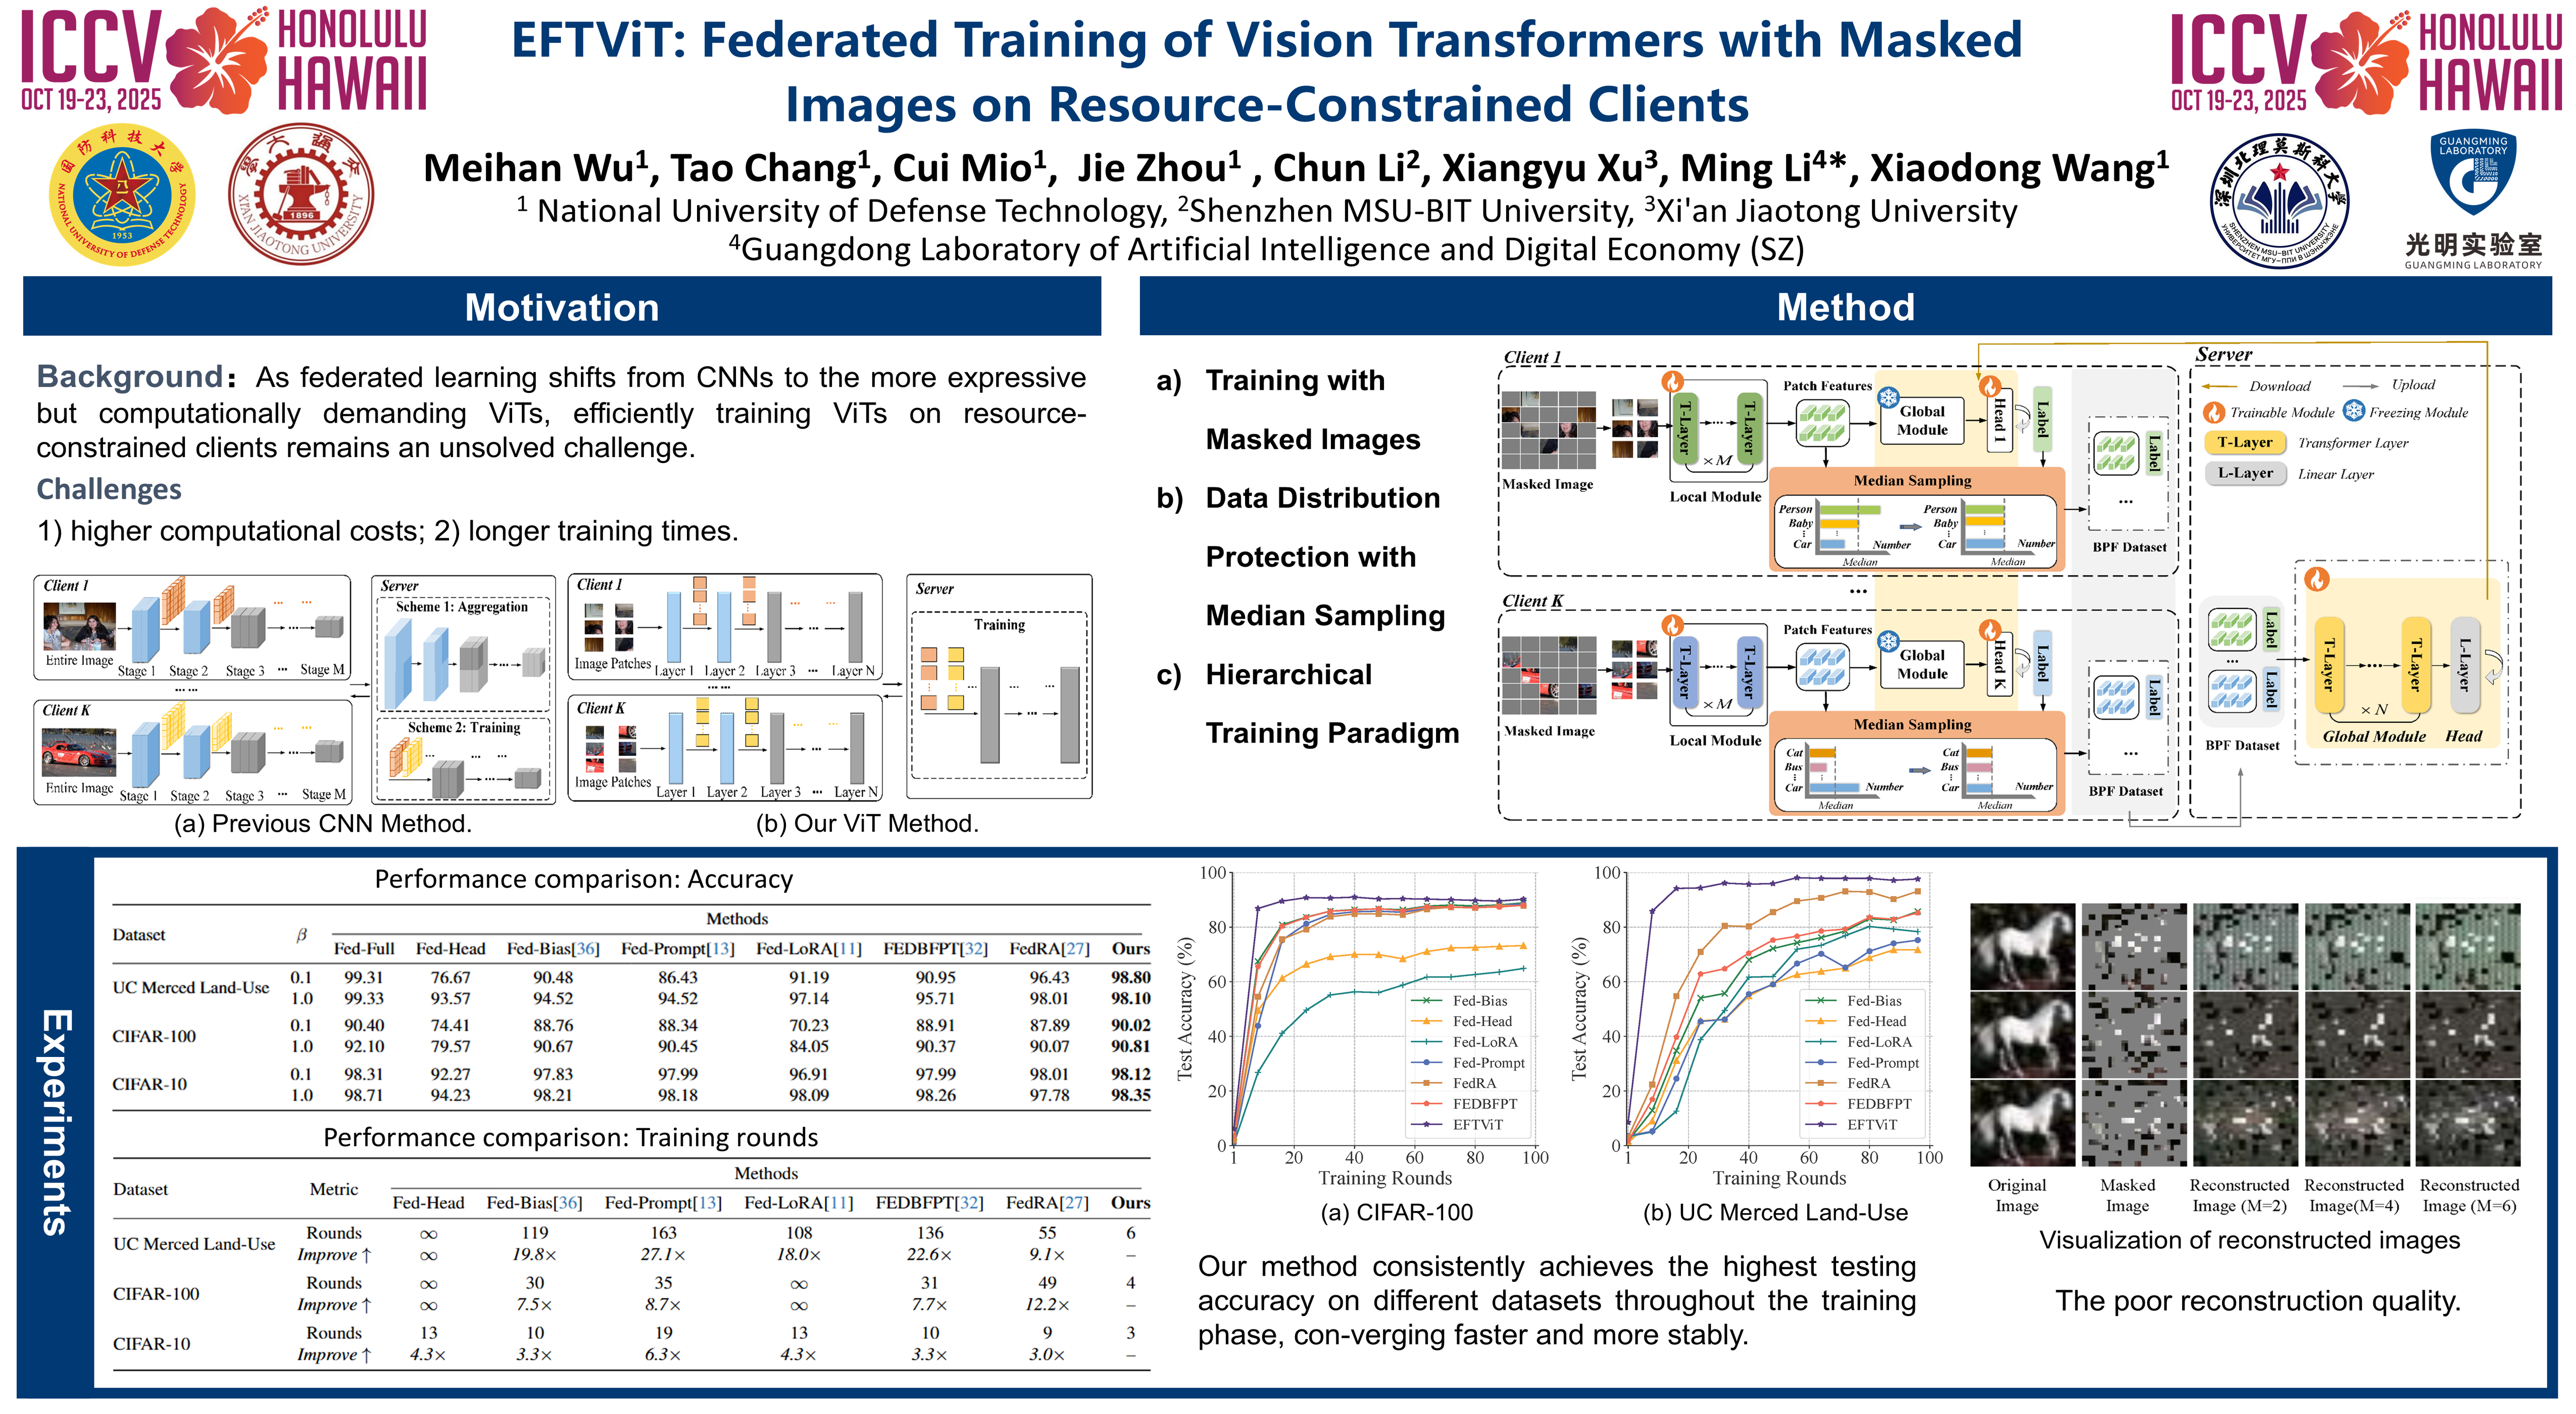
Federated learning research has recently shifted from Convolutional Neural Networks (CNNs) to Vision Transformers (ViTs) due to their superior capacity. ViTs training demands higher computational resources due to the lack of 2D inductive biases inherent in CNNs. However, efficient federated training of ViTs on resource-constrained clients remains unexplored in the community. In this paper, we propose EFTViT, a hierarchical federated framework that leverages masked images to enable efficient, full-parameter training on resource-constrained clients, offering substantial benefits for learning on heterogeneous data. In general, we patchify images and randomly mask a portion of the patches, observing that excluding them from training has minimal impact on performance while substantially reducing computation costs and enhancing data content privacy protection. Specifically, EFTViT comprises a series of lightweight local modules and a larger global module, updated independently on clients and the central server, respectively. The local modules are trained on unmasked image patches, while the global module is trained on intermediate patch features uploaded from the local client, balanced through a proposed median sampling strategy to erase client data distribution privacy. We analyze the computational complexity and privacy protection of EFTViT. We analyze the computational complexity and privacy protection of EFTViT . Extensive experiments on popular benchmarks show that EFTViT reduces local training computational cost by up to $5.6\times$, cuts local training time by up to $3.1\times$, and achieves up to 2.46\% accuracy improvement compared to existing methods.
Chat is not available.
Successful Page Load